大数据处理与存储技术 构建高效数据处理和存储服务的核心策略
随着信息技术的飞速发展,全球数据量呈现爆炸式增长,大数据已成为推动社会进步和商业创新的关键生产要素。如何高效地处理与存储海量数据,构建可靠的数据处理和存储服务,是当前企业和组织面临的核心挑战。本文将探讨大数据处理与存储的关键技术,并阐述构建高效数据处理和存储服务的策略。
一、大数据处理技术概述
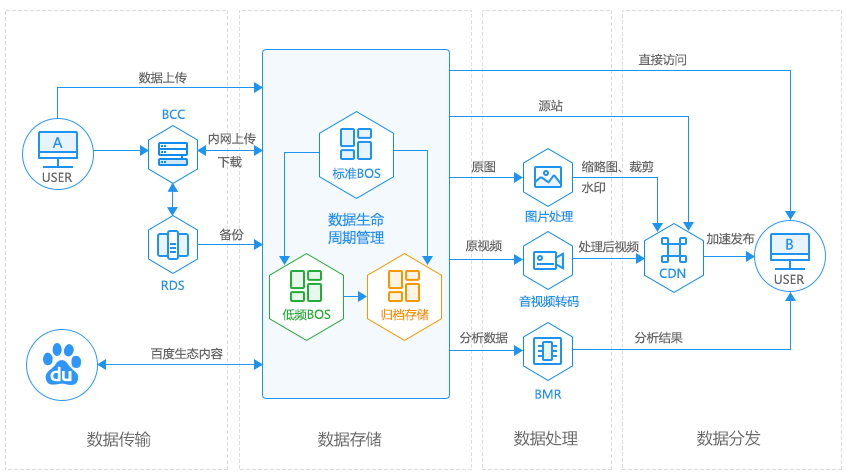
大数据处理技术旨在从海量、多源、异构的数据中快速提取价值。根据处理时效性,可分为批处理与流处理两类。批处理技术如Hadoop MapReduce、Spark,适用于历史数据的离线分析;流处理技术如Flink、Storm、Kafka Streams,则用于实时数据的连续计算。这些技术通过分布式计算框架,将任务分解到多台节点并行执行,从而提升处理效率。图计算、交互式分析等技术也在特定场景下发挥重要作用。
二、大数据存储技术概览
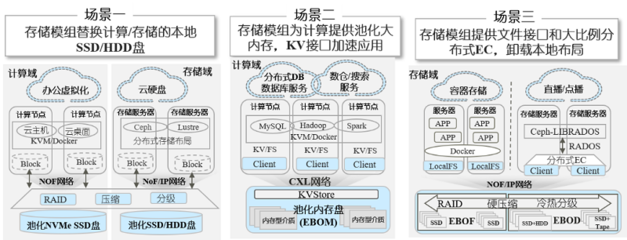
大数据存储需解决容量、性能与可靠性问题。分布式文件系统(如HDFS)通过多副本机制提供高容错性;NoSQL数据库(如HBase、Cassandra)支持海量数据的随机读写与水平扩展;对象存储(如AWS S3、Ceph)适用于非结构化数据的低成本存储;数据湖(如Delta Lake、Iceberg)则整合原始数据与结构化数据,支持多样化的分析需求。存储技术的选型需综合考虑数据模型、访问模式、一致性要求与成本等因素。
三、数据处理和存储服务的构建
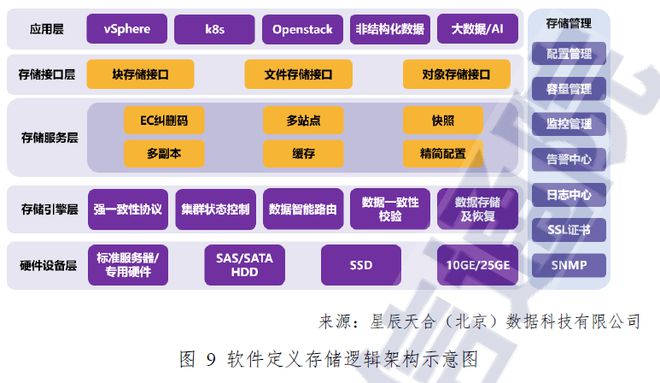
构建高效的数据处理和存储服务,需从架构设计、数据治理、运维保障等方面入手。
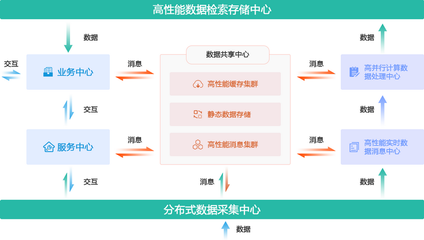
- 架构设计:采用分层架构,将数据采集、存储、计算、服务分离。例如,构建Lambda架构或Kappa架构以兼顾批处理与流处理;使用数据湖仓一体(Data Lakehouse)架构简化数据管道。
- 数据治理:建立元数据管理、数据质量监控、数据安全与隐私保护机制,确保数据的准确性、一致性和合规性。
- 运维保障:实施自动化监控与告警,优化资源调度(如YARN、Kubernetes),保障服务的高可用与弹性伸缩。
- 服务化:通过API网关、数据服务中间件,将数据处理能力封装为可复用的服务,便于业务系统集成。
四、挑战与趋势
当前,大数据处理与存储仍面临数据孤岛、实时性要求提升、成本控制等挑战。湖仓一体、边缘计算、Serverless数据处理、AI驱动的自动化运维等将成为重要趋势,推动数据处理和存储服务向更智能、更高效的方向演进。
大数据处理与存储技术是数字化时代的基石。通过合理选型技术栈、构建服务化架构、强化数据治理,企业能够打造出可靠、高效的数据处理和存储服务为业务创新提供持续动力。
如若转载,请注明出处:http://www.shujiew.com/product/44.html
更新时间:2026-11-01 01:31:20